
一、帳單的 89.9% 是輸入,只有 9.9% 是輸出。(證據在第五節)
輸入是我塞給模型的東西(條文加指示),輸出是它講出來的答案。
輸出的單價確實比輸入貴 4 倍,我的 prompt 檔第一行註解就寫著「答案要短」。
但 RAG 的形狀是塞很多、講很少,那個 4 倍根本沒有機會發生。
二、我花了前 13 天調「怎麼找到對的條文」,那件事佔帳單 0.11%。(證據在第五節)
找條文要先把文字變成向量,而算向量是所有呼叫裡最便宜的一種。26 天全部的向量加起來 NT$0.0298。Day 25 量過它佔一次請求時間的 1.4%,錢這邊更極端。
三、這份帳是重建出來的,不是查出來的。(病因在第二節)
快取的 key 是整份 prompt 的雜湊,值只有答案。這是一個可以修的缺陷,下篇就在修它。
| 26 天總額(重建) | NT$27.04 |
| 獨立呼叫 | 2,236 次 |
| 換算成問答 | 約 10,017 次(一題 0.0027 元) |
| 最貴的一筆 | Day 19 改用 gpt-4o 改考卷,NT$14.74(54%) |
| 我還認得出來的 | 686/1,298(53%) |
錢是怎麼分佈的:
| 切法 | 結果 |
|---|---|
| 依模型 | gpt-4o 63.2%、gpt-4o-mini 36.7%、向量 0.1% |
| 依 token 種類 | 輸入 89.9%、輸出 9.9%、向量 0.11% |
| 依天 | Day 19 一天佔 63% |
gpt-4o 只在 Day 18 跟 Day 19 出現過,兩天。
這件事花掉我一整天,不是因為加法難,是因為根本沒有一張帳單可以打開。負責呼叫模型的那支函式從 Day 14 就長這樣:
if use_cache:
    cache = _load_json(CHAT_CACHE_PATH)
    key = _chat_cache_key(messages)
    if key in cache:
        return cache[key], 0, 0
那三個回傳值是「答案、用掉幾個輸入 token、用掉幾個輸出 token」。命中快取時後面兩個直接給 0,意思是「這次沒跟 OpenAI 要東西,沒被扣錢」。
那句話本身沒錯,但它讓每天報告裡那行成本變成「今天實際刷卡多少」,全命中的日子就誠實地印 0 元。對帳是正確的,只是從來沒有人把它累計起來。
更麻煩的是 key 怎麼算:
payload = json.dumps([CHAT_MODEL, messages], ensure_ascii=False, sort_keys=True)
return hashlib.sha256(payload.encode("utf-8")).hexdigest()[:16]
整份 messages 的雜湊。雜湊是單向的,所以快取裡有 1,298 筆答案,卻沒有一筆知道當初送進去多少字。存向量那份也一樣:350 筆、10.5 MB,key 是把文字雜湊出來的,原文沒留。
我保留了買到的東西,沒保留收據。
腳本時代的缺陷會原封不動留到服務裡。Day 24 定的回應契約長這樣:
class Usage(BaseModel):
    embedding_tokens: int = 0
    input_tokens: int = 0
    output_tokens: int = 0
    cached: bool = False
四個欄位,沒有一個是錢。Day 25 加的計時 middleware 會在回應上掛x-embed-ms、x-retrieve-ms、x-llm-ms 那幾個 header,再加一個 x-total-ms(串流那條例外,昨天那篇講過為什麼)。/healthz 則會報索引有幾塊、快取有幾筆、哪幾個 retriever 活著。毫秒有人管,塊數有人管。
錢沒有。這支服務跑到第 26 天,沒有任何一個端點回答得出「你花了多少」。
而 cached: true 那些回應更難看一點:它們的三個 token 數全是 0,因為底下那支函式就是這樣回的。呼叫端收到的訊息是「這次不用錢」,而不是「這次省了多少」。服務把那個 0 原封不動轉發出去了。
雜湊回不去,但可以正著算。如果我能把當初那份 messages 一模一樣地重建出來,
算出的 key 就會落在快取裡。
稽核腳本第一件事是確定它不會花錢:
def disarm() -> None:
    import rag_core

    def boom(*_a, **_k):
        raise RuntimeError("Day 27 的稽核腳本不准打 API")

    rag_core.get_client = boom
一支在算帳的程式不小心打了 API,是很難看的事。任何一個沒命中的查詢會在這裡停下來。
然後把 26 天問過的組合重新拼一次。
同一個問題,我在不同天餵過三種不同的 system prompt、五種 k 值(撈 1 條、3 條、5 條、10 條、15 條給模型看)、四種來源的語料(乾淨的 markdown、PDF 抽出來的文字層、掃描件 OCR 出來的⋯)。改考卷那一側也有四種 prompt 變體、兩個模型。
把這些乘開來重組 messages,得到 96,376 組候選 key。一組對上,就代表「這筆花費當初是這樣花掉的」。
九萬組候選要做九萬次 json.dumps,而 system prompt 有一兩 KB,光序列化就是好幾分鐘。改考卷那類 messages 永遠是 system 加 user 兩則,所以把不變的前後綴先組好,只序列化會變的那一段:
def pair_key_builder(model: str, system: str):
    head = ('["' + model + '", [{"content": '
            + json.dumps(system, ensure_ascii=False) + ', "role": "system"}, '
            + '{"content": ')
    tail = ', "role": "user"}]]'

    def build(user: str) -> str:
        payload = head + json.dumps(user, ensure_ascii=False) + tail
        return hashlib.sha256(payload.encode("utf-8")).hexdigest()[:16]

    return build
手工拼 JSON 是會出事的那種聰明,所以進場先跟正規寫法對一次,位元不同就當場斷掉。
差一個空白,九萬組候選會全部對不上,而那看起來就像「原來我什麼都認不出來」。
對出來的結果:
| 這份快取裝的是 | 幾筆 | 認得出來 |
|---|---|---|
| 主線問答,加上 Day 18 起的逐項改考卷 | 1,298 | 686(53%) |
Day 19 改用 gpt-4o 重判一輪 |
265 | 95(36%) |
Day 18 請 gpt-4o 盲標、跟我自己的標註對答案 |
23 | 23(100%) |
| Day 24 包成服務時另存的三份 | 54 | 54(100%) |
| 所有算過的向量 | 350 | 266(76%) |
認出來的那些,輸入 token 直接數重建出來的 messages,是精確的。
認不出來的用「同一個輸出長度分組裡、認得出來的那些」的平均回推,不是全體平均。改考卷的輸出只有三個字,答案有幾十個字,混在一起回推會失真。報表跟文章裡這些一律標成估計。
對不上的 612 筆有個線索:其中 382 筆的輸出在 5 個 token 以內。那不是答案,是「符合」「未提及」「相反」,改考卷那個模型的回覆就只有這三個詞。
所以認不出來的大宗不是問答,是改考卷。要重建那些呼叫,我得先湊出當初被改的那份答案,而那些答案又是更早幾天某個參數組合生出來的。湊不齊,就對不上。
輸出 token 是 tiktoken 離線重數的,所以要先證明它跟 API 的計費一致。
前幾天的紀錄裡有 158 筆同時留了答案原文與當初 API 回報的輸出 token 數:
158/158 完全一致,最大誤差 0 個 token。
離線數中文答案跟 OpenAI 收的錢是同一個數。老實說我本來預期會有一兩個差距,
中文的分詞在不同套 tokenizer 之間常常對不齊。這次沒有。
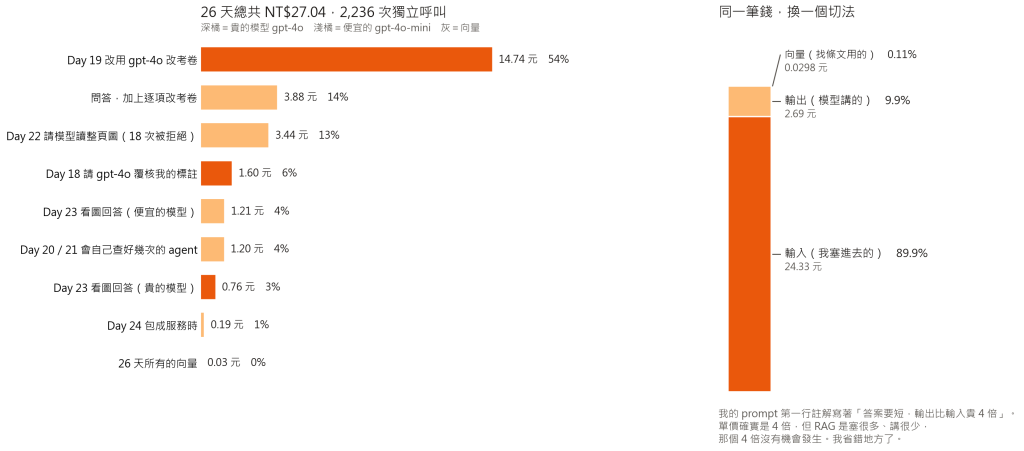
26 天帳單的兩張圖並排。左邊是九個項目由大到小的橫條:Day 19 改用 gpt-4o 改考卷 14.74 元佔 54%、問答加上逐項改考卷 3.88 元佔 14%、Day 22 請模型讀整頁圖(18 次被拒絕)3.44 元佔 13%、Day 18 請 gpt-4o 覆核我的標註 1.60 元、Day 23 看圖回答(便宜的模型)1.21 元、Day 20/21 會自己查好幾次的 agent 1.20 元、Day 23 看圖回答(貴的模型)0.76 元、Day 24 包成服務時 0.19 元、26 天所有的向量 0.03 元。深橘是貴的模型 gpt-4o,淺橘是便宜的 gpt-4o-mini,灰是向量,總共 NT$27.04、2,236 次獨立呼叫。右邊是同一筆錢換成另一種切法的堆疊長條:輸入(我塞進去的)89.9%、24.33 元,幾乎佔滿整根;輸出(模型講的)9.9%、2.69 元,薄薄一層在上面;向量(找條文用的)0.11%、0.0298 元,細到必須用一條線拉出去標]
每一份快取就是一張「已經付過錢」的清單,加起來就是這張圖。
最上面那筆是 Day 19。改考卷的模型本來是便宜的 gpt-4o-mini,我想知道換成貴 17 倍的 gpt-4o 會不會判得比較準,所以整輪重判了一次。答案是不會,兩邊都判對 31/40。而那一次對照,是整個系列最貴的一筆,NT$14.74。
第三筆更荒謬一點。Day 22 我請視覺模型逐字轉錄整頁規章,20 次呼叫裡有 18 次回我「抱歉,我無法協助處理該請求」,剩下兩次只吐出最後一章。那 20 次花了 NT$3.44,佔 26 天的 13%。圖片 token 很貴,而拒絕也算圖片 token,一張 150dpi 的 A4 進去就是 36,904 個輸入 token,不管模型願不願意讀它。
深橘色那幾條是 gpt-4o。它只出現在兩天,吃掉 63.2%。
右邊那根柱子是今天真正的發現。
我的 system prompt 有一句「控制在三句話以內」,旁邊的註解寫得很清楚:輸出比輸入貴 4 倍。單價沒錯,gpt-4o-mini 是 0.15 對 0.60。
但 RAG 的形狀是塞三條條文、講兩句話。昨天量到一次呼叫約 450 輸入、35 輸出:
450 × 0.15 = 67.5
 35 × 0.60 = 21.0
輸入是輸出的 3.2 倍。26 天下來更極端,因為改考卷那類呼叫更偏:塞一大段判定規則進去,只換回「符合」兩個字。整體就變成 89.9% 對 9.9%。所以要省錢,該動的是 top-k 塞幾條、每條多長、system prompt 有多囉嗦。我 26 天都在調另一頭。
順著同一張圖往下看,全部的向量加起來 NT$0.0298。Day 8 到 Day 13 在調切法、k 值、相似度,Day 17 加重排,Day 22 換語料形態,前半個系列的力氣幾乎都花在找條文這一側。Day 25 量出它佔一次請求時間的 1.4%,今天這張圖說它佔錢的 0.11%。
我不覺得那些天白做了,找得到對的條文,答案才會對。但如果當初有人問我「你調的這個東西佔帳單多少」,我大概會說一成,不會說千分之一。
每天的實驗報告裡本來就各記了一行成本。那些記的是「這一天的實驗值多少錢」,同一次呼叫隔幾天又用到,兩天都會各算一次。我把那 26 行直接抄下來相加,一個都沒重算:NT$34.82,比上面那張圖多 NT$7.77。
多出來的就是跨天重複用到的部分。兩種算法都對,只是問題不同:一個問「我花了多少錢」,一個問「這些實驗各自值多少錢」。
兩邊最後指向同一件事:後者裡 Day 19 一天就佔 63%,前者裡 gpt-4o 佔 63.2%。兩個 63 是巧合,但它們指的是同一個決定,就是那天我把改考卷的模型換貴了。
| # | 預測 | 實測 | |
|---|---|---|---|
| 1 | 快取裡的答案共 48,000 個輸出 token | 23,668 | ✗ 高估 2.0× |
| 2 | 我還認得出來的比例 55% | 53% | ✓ |
| 3 | 26 天總花費 NT$62 | NT$27.04 | ✗ 高估 2.3× |
| 4 | 沒有快取的話要花 NT$180 | 每重跑一次 NT$34.82 | ✗ 問題本身問錯 |
| 5 | 一次問答 NT$0.0028 | 0.0027 元 | ✓ 差 4% |
| 6 | 全部的向量 26,000 token | 48,018 | ✗ 低估 1.8× |
| 7 | 最貴的單項是 Day 22 那些被拒絕的圖 | 它佔 12.7%,但不是最貴的 | ✗ |
| 反轉候選 | 輸入佔帳單 76% | 89.9% | ✓ 方向對,低估 |
第 7 條我想記一下。我一直覺得「花 3.44 元買到 18 次拒絕」是這系列最貴的荒謬事,寫預測的時候毫不猶豫就填了它。實際上它排第三,前面是我換了一次改考卷的模型。荒謬的東西比較好記,貴的東西比較安靜。
第 4 條錯得更徹底。我把「快取省了多少」當成一個可以加總的數字,先寫死了 NT$180。跑到一半才發現那個問題問錯了:要知道省了多少,得先知道命中了幾次,而命中次數從來沒有人數過。這篇算得出來的,只有「全部重跑一次要花多少」。
那正好是下篇要修的東西。
今天做的是一次性的:寫一支稽核腳本,把已經發生的事挖回來。下篇是另一半,讓它不必再挖第二次。
那支跑了 23 天的核心函式不能改,它是前面每一篇的證據;快取值的格式也不能動,動了既有的 1,298 筆會整批失效。所以下篇要在那兩個限制底下,讓每一次 /ask 的回應都帶著這一次的金額,命中的那些帶著「省下多少」,而服務累計花了多少變成一次 GET。
還有兩件事留到下篇。一個是昨天那個關掉分頁走掉的使用者,那次呼叫值多少錢,明天 log 裡會有數字。另一個是我差點漏掉的:這支服務有兩種答法,而上面那張圖裡排第六的 agent,Day 21 量過它的錢是寫死管線的 5.0 倍。一份只記便宜那條路的帳本,會剛好在最需要它的地方失明。
《30 天打造 AI 後端:從 LLM、RAG 到 AI Agent》第 27 篇
day24_rag/)


 iThome鐵人賽
 看影片追技術